惠普服务器 · HPE 存储
HPE Server & Storage
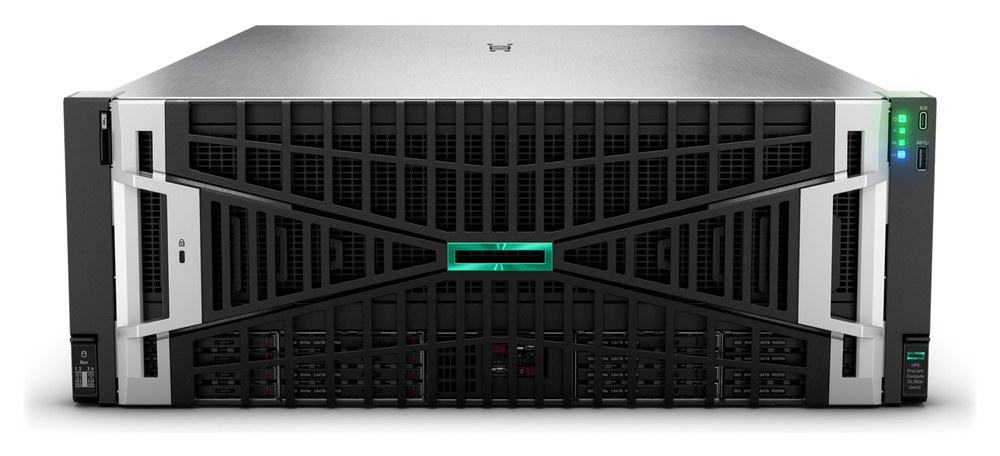
做 AI 项目的人常问:到底该买通用 GPU 服务器,还是直接上大内存的超级芯片机型?答案取决于模型规模、是推理还是训练、以及机房的供电与散热能给到什么程度。
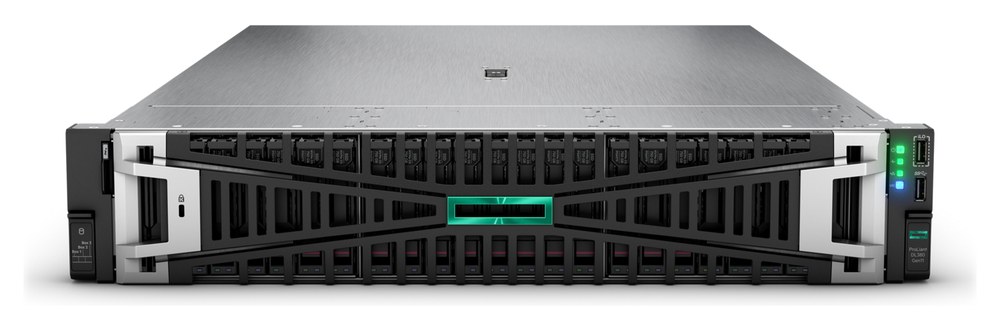
DL380a Gen12 是在 2U 机箱里塞多块加速卡的设计,适合推理服务、视频分析、虚拟化 GPU 这类"多实例并行"的场景。它的好处是通用:标准机柜能装,供电按常规双路配置,配件与主流服务器共用,运维习惯不需要重学。
选这类机型要重点确认三件事:加速卡的功耗与散热是否在机箱设计范围内、PCIe 通道是否够、机柜单柜功率是否撑得住。具体规格见 DL380a Gen12 产品页。
DL384 Gen12 面向的是单机需要极大内存与高带宽的场景,典型是大模型推理、内存数据库、需要把模型整体驻留的场景。它不是"更多卡"的思路,而是"更大统一内存"的思路,适合模型规模大、切分成本高的部署方式。
这类机器的门槛在机房条件:功耗高、散热要求高,普通机柜未必扛得住。部署前要确认配电回路、机柜承重与冷风供给。资料见 DL384 Gen12 产品页。
推理看重的是并发与延迟,配置上偏向多卡、适中显存、稳定的网络;训练看重的是卡间互联带宽与整机扩展,往往要多机集群配合。把训练用的配置直接拿来做推理,成本会明显偏高;反过来用推理机做训练,往往跑不动。
AI 项目最容易出问题的不是服务器本身,而是机房配套。把模型规模、并发要求与机房现状告诉我们,先做供电与散热的可行性核对,再定机型,能省掉不少返工。